
Y es que el modelo, cuando no está seguro de algo, tiene una idea preconcebida en su cabeza antes de buscar la respuesta correcta, y persigue corroborar que lo que piensa es correcto, aunque eso a veces no sea la mejor respuesta para ti.
En este artículo recopilo información que investigadores como David, Olivier de Segonzac, Metehan Yeşilyurt, David Konitzny y Suganthan Mohanadasan han encontrado sobre el funcionamiento de ChatGPT, y te explico cómo busca y cómo puedes influir en sus respuestas.
¿Cómo decide ChatGPT si buscar o no?
ChatGPT no decide si buscar o no, sino que existe todo un sistema secuencial donde otros LLMs se encargan de guiar las acciones del modelo grande, que es con el que el usuario interactúa.
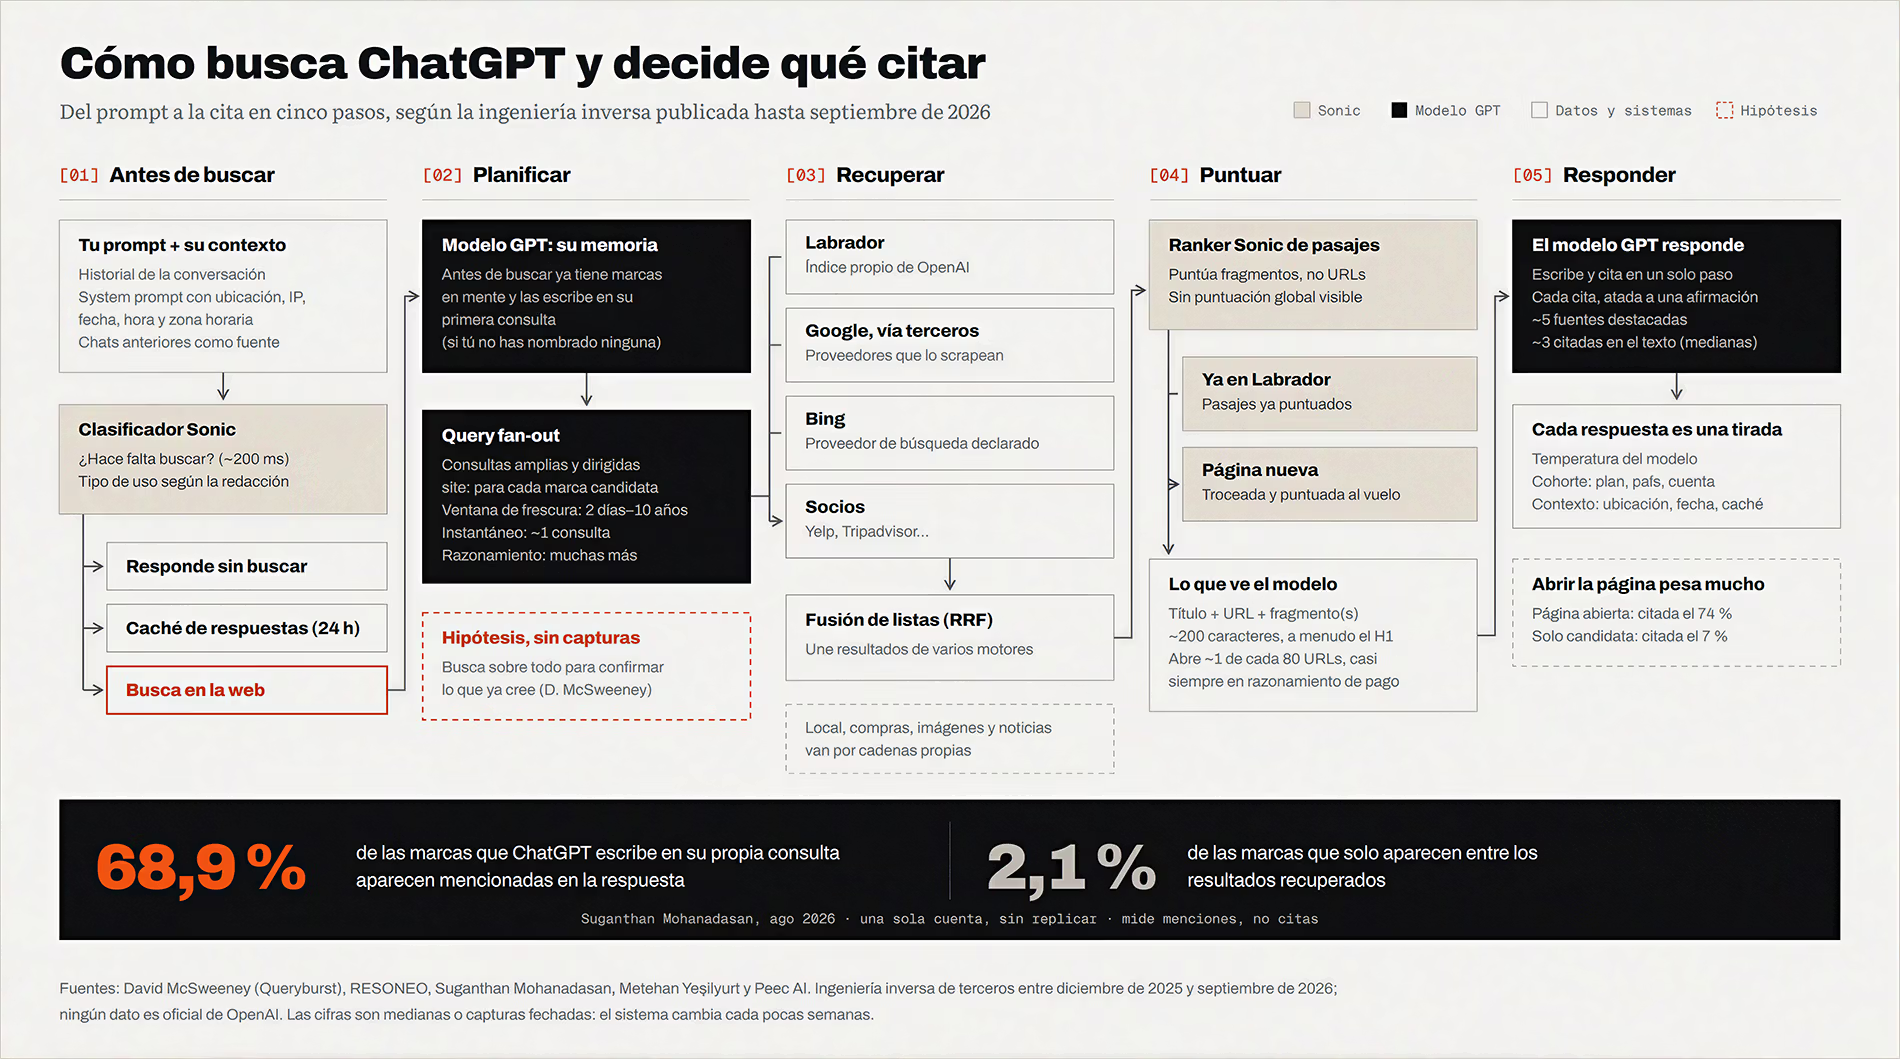
Cuando envías un prompt en el chat, el sistema no sólo procesa ese prompt, sino también toda la conversación, el system prompt y la memoria (si la tienes activada). Si tienes fuentes personales como Gmail conectadas, también se procesan, así como tu ubicación, fecha, hora y zona horaria.
¿Y qué se hace con toda esa información? Pues otro modelo, un clasificador (de la familia Sonic), lee el prompt y decide si la respuesta necesita buscar en la web o no en 200 ms (un parpadeo). Al mismo tiempo, se clasifica el prompt como búsqueda instantánea, compras, texto, local, razonamiento o generación de imagen para que avance al siguiente paso correctamente.
Que se clasifique en un tipo de uso u otro depende de cómo escribas el prompt, no solo de la tarea en sí. Eso explica por qué a veces tienes que reescribir tu mensaje o abrir un nuevo chat porque, aunque no pides la generación de una imagen, empieza a crearla (antes pasaba con más frecuencia; ahora es cada vez más raro, pero pasa).
El equipo de Resoneo descubrió que hay una caché de respuestas. Para temas efímeros como las noticias, dura 24 horas, para contenido evergreen es mucho más larga. Si una persona ha preguntado algo similar en esa franja de tiempo, se utiliza esa caché para que el modelo responda sin buscar.
Todo esto sólo para que Sonic decida si
- Se responde sin buscar.
- Se responde desde la caché.
- Se responde con una nueva búsqueda.
Cuando Sonic decide que hay que hacer una nueva búsqueda, el modelo que has seleccionado en ChatGPT se encarga de leer el prompt y consultar su memoria (datos de entrenamiento) antes de buscar. Es algo similar a lo que hacemos nosotros cuando tenemos que hacer algo: nos vienen cosas a la cabeza y entonces decidimos qué buscar.
Si, por ejemplo, necesitas que ChatGPT te recomiende algo, el modelo ya tiene en mente nombres de marca (que conoce por sus datos de entrenamiento) en su primera consulta, antes de buscar.
Si al mandar el mensaje nombraste alguna marca, el modelo la tiene en cuenta y la va a utilizar.
El prompt se va a organizar de tal forma que el modelo genere varias consultas (query fan-out)
en forma de preguntas amplias y dirigidas. Si hay alguna marca, utiliza el comando site: para
verificar datos, y esto varía bastante si el usuario utiliza el modo instantáneo o el de razonamiento (en
uno está restringido por tiempo y en el otro no).
Según lo que pidas, el LLM va a fijar un límite máximo de fecha a los resultados, que puede ir desde unas 48 horas a 10 años. No es lo mismo pedir información de noticias de última hora que un dato que no cambia con el tiempo.
Volviendo a la marca, si ésta aparece en las consultas que escribe ChatGPT, tiene una probabilidad mucho mayor de ser mencionada (más del 50 %), mientras que si la marca aparece en los textos que el modelo recupera, la probabilidad de mención es muy baja (inferior al 5 %).
Esto es así porque, como te decía antes, el modelo tiene sus opiniones sobre la respuesta y las consultas fan-out sirven para confirmarlas.
¿Dónde busca ChatGPT?
En su propio índice (Labrador), en proveedores externos que scrapean Google, en Bing, y en socios como Yelp o Foursquare.
Labrador es un sistema de indexación que tiene varias verticales, o dicho de otro modo, varios índices especializados como por ejemplo Wikipedia, noticias, Reddit, Youtube, PDFs, sitios locales... Y dentro de este sistema también se incluyen los medios que tienen acuerdos con OpenAI, que no se rastrean en directo, sino que llegan como un resumen generado de antemano y se colocan antes que cualquier resultado de la web.
Que se elija uno u otro lugar donde buscar depende de la pregunta que hagas, del tipo de pregunta y del modo de razonamiento que hayas aplicado (y es posible que, si eres un usuario de pago, también influya en cierta medida).
¿Qué pasa cuando ChatGPT busca?
Una vez se han lanzado las consultas y llegan los resultados, el modelo GPT no utiliza el contenido completo de las URLs, sino sus snippets puntuados por candidato.
Los snippets son el título y un pasaje de 200 caracteres extraído del texto de la URL, que la mayoría de las veces incluye el H1.
Sabemos que para ordenarlos se utiliza Reciprocal Rank Fusion y que luego un modelo de ranking (también de la familia Sonic) puntúa los pasajes de las URLs candidatas para citarse.
De esas páginas, las que no estaban en el índice se trocean en fragmentos (chunks) y se puntúan sobre la marcha (por el mismo modelo de Sonic). Si la página ya estaba en Labrador, se reciben los pasajes ya puntuados.
Para partir las páginas en chunks, antes tienen que convertirse en texto plano y se divide en bloques de unas 170 palabras más o menos. Al modelo grande le van a llegar entre 1 y 3 de esos bloques por cada fuente.
Para puntuar a cada chunk, el sistema comprueba cuántos términos de la consulta aparecen en él. Los fragmentos que tienen más de la mitad de las palabras de la consulta tienen casi 3 veces más probabilidades de puntuar alto que en los que aparece una cuarta parte de ellas.
¿Y eso es lo que vemos cuando ChatGPT nos da la respuesta? ¡No! Con esa lista, el modelo decide qué hacer sin leer las URLs completas. Según un estudio de Resoneo, de las páginas recuperadas se abren en torno a 1 de cada 80 (¡!) y, casi siempre, si el modo razonamiento está activado.
El modelo GPT compara cada pasaje con su sesgo (aunque esto último es una teoría que no se ha podido confirmar por ahora) y elige unas pocas fuentes para citar y otras para destacar. Antes de escribir nada, el modelo vuelve a ordenar los dominios en su proceso de razonamiento..
Y por fin, escribe la respuesta y añade las citas, todo en un único paso.
Pero eso no quiere decir que siempre que alguien pregunte lo mismo, el modelo cite a tu marca.
¿¡Qué me estás contando!?
Pues eso. El modelo tiene un parámetro interno que se llama temperatura, que controla el nivel de aleatoriedad y creatividad de las respuestas que ChatGPT escribe. Eso significa que, incluso haciendo la misma pregunta al mismo modelo en el mismo plan, la respuesta que recibes puede variar, porque la generación de la respuesta está sujeta a la configuración de temperatura del modelo.
Súmale a eso que por cada país, cuenta y plan se hacen experimentos, y que según el modelo que utilices las respuestas serán diferentes.
Sin ir más lejos, cuando ChatGPT pasó a GPT-6 en octubre, las búsquedas con "site:" cayeron de cerca del 23% al 8%, y empezó a hacer menos consultas, pero más largas.
Además Open AI puede cambiar el system prompt de ChatGPT con una actualización o cambio de modelo, y eso afecta a su comportamiento, por lo que es interesante estar al día para conocer cómo funciona. En el caso de GPT6 sus instrucciones dicen (no literalmente): "prefiere fuentes con autoridad, relevantes y recientes, cita cada afirmación ordenando las fuentes por lo bien que la respaldan. En temas de actualidad, cita fuentes con una fecha explícita, y usa y cita Reddit para opiniones y recomendaciones".
Precisamente por eso, hay que interpretar con una pizca de sal cómo se hace prompt tracking.
¿Qué necesitas para que ChatGPT cite tu contenido?
Una página, para ser citada, necesita:
- Que el usuario haga un prompt que active la búsqueda.
- Que pueda ser rastreada por los motores de búsqueda de ChatGPT: OAI-SearchBot, Google y Bing.
- Que sea accesible y renderice su contenido sin JavaScript.
- Que el contenido entre dentro de la ventana de frescura.
- Que sus pasajes sean extraíbles y cubran los términos de las consultas.
- Que sobreviva a la criba que hace el modelo Sonic antes de enviarla al modelo grande.
- Que la generación del modelo grande (por temperatura) cite a la página.
Es decir, podemos influir en
- El entrenamiento del modelo.
- El sesgo del modelo sobre el sitio o la marca.
- La accesibilidad del sitio para los rastreadores que utiliza OpenAI.
- La renderización del contenido sin JS.
- La velocidad de actualización del contenido.
- La extracción de snippets que se utilizan en las citaciones.
- La extracción y puntuación de pasajes (las citas se atan a afirmaciones concretas).
El cómo hacerlo lo explicaré en otro momento, pero lo importante es que para OpenAI, Anthropic, Google, etc., cada conversación que tienes con sus modelos cuesta dinero.
Todo este sistema que OpenAI ha construido no es solo para que te lleves la mejor experiencia (y te suscribas o mejores tu plan), sino para ahorrar costes.
No es un secreto que la industria de la IA, y toda la economía que gira a su alrededor, está sufriendo por reducir gastos. Los modelos cada vez son más caros, los precios de los componentes electrónicos se están disparando (¡la RAM está hasta 5 veces más cara que hace un año!) y la propia OpenAI ya está ajustando precios al alza (hola, nuevo plan de 500 dólares tras nerfear el de 200).
Ten en cuenta que estas empresas no solo tienen que producir los mejores modelos, sino crecer y ser rentables, y uno de sus mayores gastos (si no el mayor) lo provocamos nosotros, los usuarios, a diario.